이 글은 ChatGPT의 도움을 받아 작성되었습니다.
들어가며
의료인공지능이 만드는 결과물이 조금씩 달라지고 있습니다. 기존의 폐결절 탐지 AI는 영상에서 의심 부위를 표시하거나 확률을 제시했습니다. 이제는 흉부 X-ray를 보고 판독문의 초안을 작성하는 생성형 AI도 등장했습니다. 결과물이 숫자나 표시가 아니라 자연어 문장이라는 점은 사소한 차이처럼 보이지만, 의료기기를 평가하고 허가하는 입장에서는 꽤나 어려운 문제를 던집니다.
문장 하나하나에 정답이 정해져 있지 않은데 무엇을 기준으로 정확도를 평가해야 할까요? 영상에서 관찰되지 않은 소견을 그럴듯하게 지어내는 환각(hallucination)은 어떻게 검증해야 할까요? 같은 영상을 넣더라도 표현이 달라질 수 있다면, 어디까지를 허용할 수 있는 변동으로 보아야 할까요?
2026년에는 이 질문에 대해 대비되는 두 가지 사례가 나왔습니다. 미국 FDA는 8월에 생성형 AI 의료기기 규제를 위한 Discussion Paper를 발표하며 가능한 평가 체계를 논의했습니다. 한국 식품의약품안전처는 그보다 앞선 4월에 Soombit.ai의 AIRead-CXR을 국내 최초의 생성형 AI 기반 디지털의료기기로 허가했다고 발표했지요.
한쪽은 앞으로 어떤 방식으로 평가할 것인지 질문을 던지는 문서이고, 다른 한쪽은 이미 구체적인 사용목적을 가진 제품이 허가된 사례입니다. 서로 같은 종류의 자료는 아니지만, 함께 보면 생성형 AI가 의료기기가 되기 위해 무엇을 증명해야 하는지 생각해 볼 수 있습니다.
미국 FDA: 생성형 AI 의료기기를 어떻게 평가할 것인가?
2026년 8월 FDA의 Center for Devices and Radiological Health(CDRH)는 Considerations for the Regulation of Generative AI-Enabled Medical Devices: Discussion Paper and Request for Feedback를 발표했습니다.[1]
먼저 분명히 해야 할 점이 있습니다. 이 문서는 확정된 가이드라인이나 새 규제 요건이 아닙니다.[1] FDA가 이해관계자의 의견을 수렴하기 위해 제시한 논의문이며, FDA가 제시한 선택지를 곧바로 현재의 의무사항으로 받아들여서는 안 됩니다.
모든 생성형 AI가 의료기기는 아니다
먼저 FDA가 이 문서에서 이야기하는 대상부터 구분할 필요가 있습니다.
FDA는 AI 기술 자체를 의료기기로 규제하지 않습니다. AI로 구현했든, 전통적인 알고리즘으로 구현했든, 어떤 소프트웨어 기능(function)이 의료기기의 정의에 해당하는지와 그 기능의 Intended Use가 중요합니다. 하나의 제품 안에 의료기기인 기능과 의료기기가 아닌 기능이 함께 존재할 수도 있습니다.
그러니까 의료진의 문서 작성을 도와주는 LLM을 사용한다는 사실만으로 그 제품이 곧바로 FDA 규제 대상 의료기기가 되는 것은 아닙니다. 반대로 생성형 AI가 임상적 판단이나 환자의 치료행동에 영향을 주는 의료기기 기능을 수행한다면 규제 문제가 발생할 수 있겠지요. 개별 기능에 대한 판단에는 기존의 의료기기 정의, 21 USC 360j(o)에 해당하는 FD&C Act 520(o)의 소프트웨어 제외 조항, FDA 정책 등을 함께 고려해야 합니다.
그럼에도 생성형 AI 의료기기가 기존 소프트웨어 의료기기와 다른 점은 분명합니다.
- Open-ended input/output: 입력도 자유롭고, 출력도 반드시 한 가지 정답으로 정해지지 않습니다.
- Variable output: 같은 질문을 반복해도 답변이 달라질 수 있습니다.
- Multi-turn conversation: 한 번의 질문이 아니라 대화를 이어가면서 기능의 성격이 변할 수 있습니다.
- Model evolution: 파운데이션 모델, prompt, retrieval, guardrail, orchestration 등이 바뀌면서 제품 동작도 달라질 수 있습니다.
- Third-party dependency: 의료기기 제조사가 직접 개발하지 않은 파운데이션 모델에 의존할 수도 있습니다.
문제는 바로 여기에 있습니다. 우리가 검증해야 하는 것은 모델의 정답률일까요, 아니면 그 모델을 탑재한 의료기기 제품의 임상적 행동일까요?
FDA의 논의는 후자에 가깝습니다.
생성형 AI의 위험도를 어떻게 평가할까?
FDA는 생성형 AI 의료기기의 위험을 이해하기 위한 하나의 방법으로 2축 위험도 프레임워크(two-axis risk framework)를 제시합니다. 가로축은 AI가 수행하는 활동의 성격과 독립성(Activity), 세로축은 잘못된 출력에 의존했을 때 발생할 수 있는 위해의 심각도(Consequences)입니다.
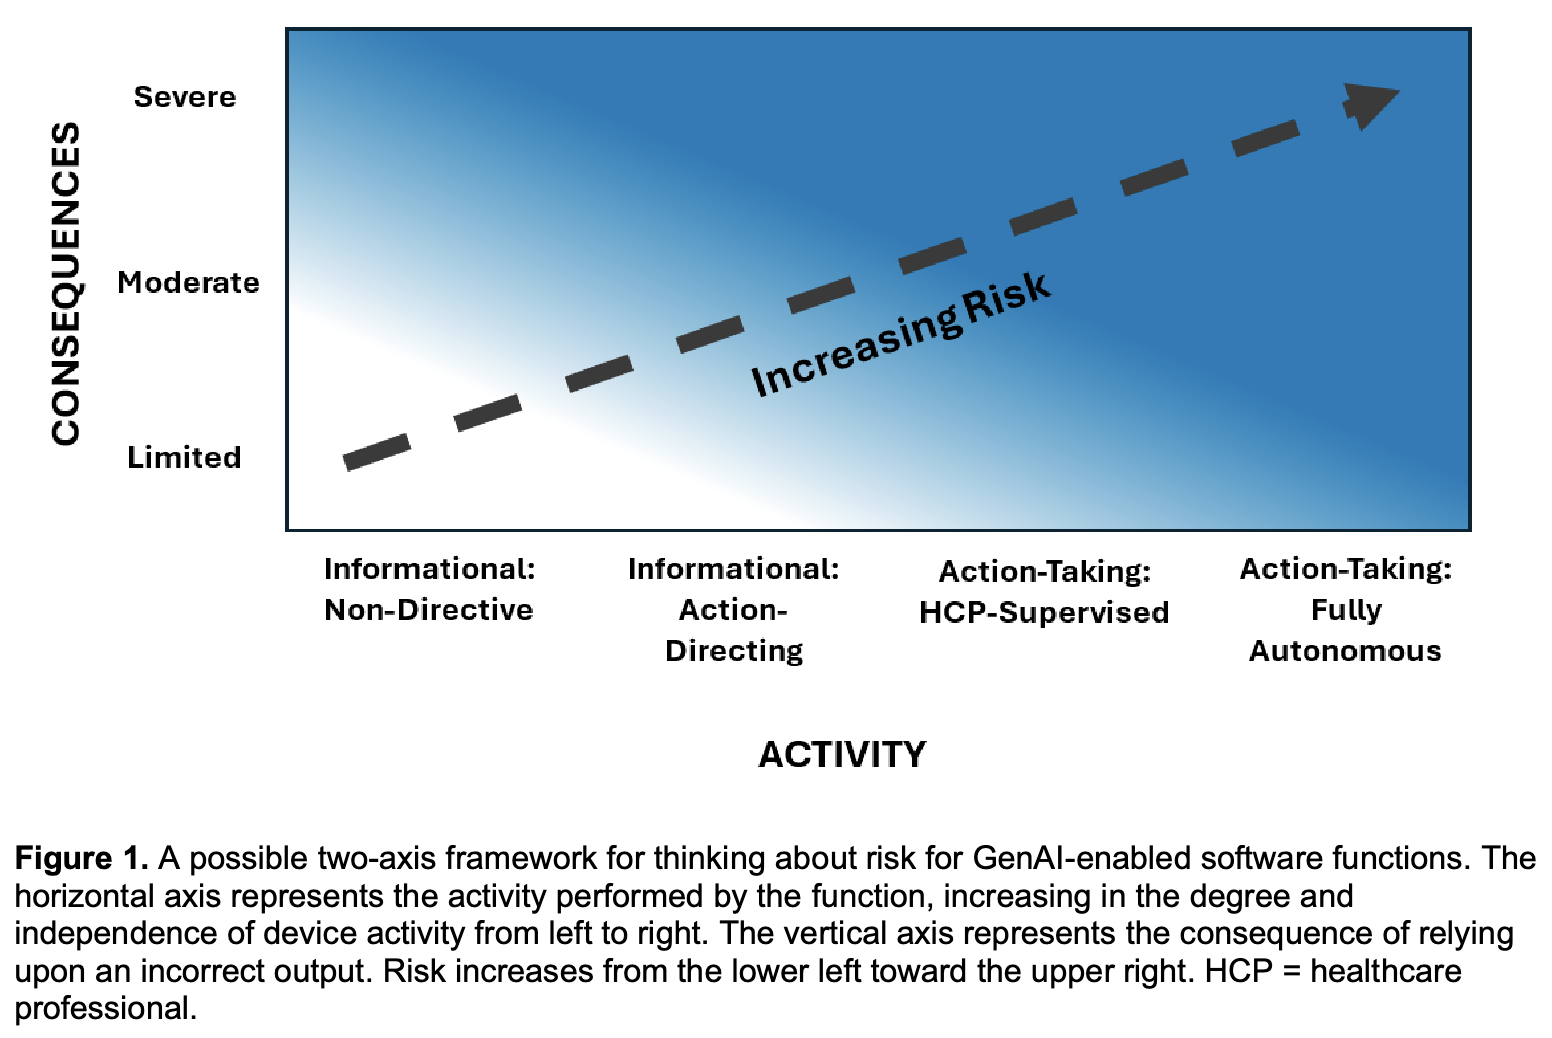
활동 수준은 대략 다음과 같은 연속선으로 생각할 수 있습니다.
| 활동 수준 | 의미 | 예시 |
|---|---|---|
| Informational: non-directive | 정보를 제공하지만 특정 행동을 지시하지 않음 | 심혈관질환의 위험도 정보를 제시 |
| Informational: action-directing | 정보를 통해 특정 행동을 유도 | 응급실 방문 여부를 강하게 권고 |
| Action-taking: HCP-supervised | 의료진 감독하에 행동을 실행 | 의료진이 감독하는 임상 오더 수행 |
| Action-taking: fully autonomous | 독립적으로 행동을 실행 | 자율적인 임상 처치 오더 실행 |
그렇다고 오른쪽에 위치한 기능이 무조건 같은 등급의 위험을 갖는 것은 아닙니다. 잘못된 일반의약품 사용 권고와 잘못된 인슐린 투여량 권고는 결과의 심각성이 다르기 때문입니다. 따라서 AI의 독립성과 잘못된 행동의 결과를 함께 보자는 것입니다.
이 프레임워크는 FDA의 확정된 의료기기 등급 분류표가 아니라 위험을 생각하기 위한 heuristic입니다. FDA도 행동의 가역성, 시간적 긴급성, 안전장치, 결과의 출처 추적성 같은 다른 요소를 추가로 고려해야 하는지 의견을 구하고 있습니다.
Action-directing이라는 개념
이 문서에서 특히 재미있는 부분입니다. FDA는 정보를 전달하는 방식만으로도 의료기기의 위험이 달라질 수 있다고 봅니다.
예를 들어 혈압약 lisinopril에 대해서 다음과 같이 답변한다고 합시다.
- “혈압이 치료 목표보다 높을 때 lisinopril의 용량을 늘리는 경우가 있습니다.“
- “현재와 비슷한 상황에서는 의사들이 용량을 늘리는 경우가 많습니다.“
- “용량을 증량하는 것을 권고합니다.“
- “매일 10 mg에서 20 mg으로 증량하세요.“
네 문장 모두 약물 증량이라는 같은 방향을 가리키지만, 마지막으로 갈수록 환자에게 구체적인 행동을 유도합니다. FDA는 이러한 directiveness가 이분법적 구분이 아니라 연속적인 정도의 차이일 수 있다고 이야기합니다.
더 재미있는 것은 “의사와 상의하세요“ 또는 “저는 의료 전문가가 아닙니다“라는 면책문구를 넣는다고 해서 이미 행동을 유도한 답변의 성격이 사라지는 것은 아니라는 점입니다.
또한 처음에는 단순한 건강정보를 제공하다가 사용자가 질문을 이어가면서 구체적인 약물 복용 지침을 주게 되는 multi-turn conversation도 고려합니다. 한 번의 prompt-response만 평가해서는 놓칠 수 있는 문제이지요.
이 논의가 규제적 요건으로 발전한다면, 제품의 IfU에 “의사의 판단을 대체하지 않음“이라고 적어두는 것과 실제 대화에서 AI가 의료행위를 지시하지 않는 것은 별도로 검증해야 할 문제가 될 수 있습니다. 다만 이는 문서를 읽고 도출한 시사점이지, 현재 FDA가 모든 생성형 AI 제품에 요구하는 새로운 의무라는 뜻은 아닙니다.
누가 AI의 답변을 받는지도 중요하다
같은 답변이라도 환자가 직접 받는지, 의료진이 받는지에 따라 위험이 달라질 수 있습니다. 전문적인 지식이 부족한 환자는 AI가 틀린 답변을 하더라도 오류를 알아차리기 어렵기 때문입니다.
그런데 FDA는 여기서 한 가지 균형도 고민합니다. 환자가 의료정보를 더 쉽게 얻는 것은 분명히 가치가 있고, 환자의 판단 능력을 과소평가하는 의료적 온정주의(medical paternalism)도 피해야 합니다. 또 일반의가 전문의 수준의 질문을 다루도록 돕는 AI는 접근성을 개선할 수 있지만, 일반의가 AI의 전문적인 오류를 검증하기 어려운 상황도 있을 수 있습니다.
결국 핵심은 단순히 환자용이냐 의료진용이냐가 아니라, 해당 사용자가 AI의 결과를 독립적으로 평가하고 적절히 대응할 수 있는가입니다.
의료 AI를 의사처럼 평가한다? Competency-based approach
이 문서의 중심이라고 생각되는 내용입니다.
의사 국가시험이나 전문의 시험을 생각해 봅시다. 의사가 평생 만나게 될 모든 환자를 미리 시험해 볼 수는 없습니다. 그 대신 기초 의학 지식과 임상 추론 능력을 평가하고, 임상 실습과 전공의 수련 같은 감독하 실무를 거친 다음 실제 진료에서도 역량을 확인합니다.
FDA는 생성형 AI 의료기기에도 이런 접근을 참고할 수 있지 않겠느냐고 묻습니다. 이름하여 Competency-based approach입니다.
크게 두 부분으로 이루어집니다.
- Device benchmarking: 사전에 정의된 시험을 통해 안전성, 임상 능력, 일반화 능력 등을 평가
- Clinical confirmation: 실제 또는 임상을 대표하는 환경에서 그 능력이 확인되는지 검증
여기서 중요한 것은 시험의 대상이 LLM의 기반 모델 자체가 아니라 실제 배포될 설정의 최종 의료기기라는 것입니다. 동일한 LLM이라도 prompt, RAG, 외부 도구, 사용자 인터페이스와 guardrail을 어떻게 구성했는지에 따라 의료기기로서의 동작이 달라지니까요.
Device benchmarking에서는 무엇을 평가할까?
FDA는 Appendix A에서 다음과 같은 평가 영역을 제시합니다.
| 구분 | 평가 요소 | 간단한 설명 |
|---|---|---|
| Safety | S.1 Safety-critical recognition and escalation | 위험한 상황을 알아차리고 적절히 진료를 권고하는가 |
| Safety | S.2 Scope maintenance and boundary adherence | 허용된 사용범위를 지키는가 |
| Safety | S.3 Calibration, uncertainty communication, and clinical deferral | 불확실성을 표현하고 필요할 때 의료진에게 판단을 넘기는가 |
| Clinical proficiency | E.1 Clinical knowledge and task fidelity | 임상 지식과 맡은 task을 정확하게 수행하는가 |
| Clinical proficiency | E.2 Information gathering and clinical analysis | 부족한 정보를 묻고 종합적으로 추론하는가 |
| Clinical proficiency | E.3 Quantitative and measurement analysis | 용량, 단위, 측정값을 올바르게 해석하는가 |
| Clinical proficiency | E.4 Communication quality and user comprehension | 사용자에게 이해 가능하고 적절하게 설명하는가 |
| Generalizability | R.1 Robustness, reliability, and reproducibility | 질문의 표현과 대화 환경이 바뀌어도 핵심 판단이 일관되는가 |
| Generalizability | R.2 Subgroup performance | 주요 환자 하위집단에서 성능이 유지되는가 |
| Agentic AI | A.1 Agentic AI competencies | 다단계 작업과 도구 사용을 안전하게 수행하는가 |
물론 모든 의료기기에 이 10개 항목을 전부 동일하게 적용하자는 뜻은 아닙니다. Intended Use와 위험도에 따라 필요한 항목, 시험의 강도, 합격 기준이 달라질 수 있다는 설명입니다.
여기서 몇 가지 눈에 띄는 부분이 있습니다.
첫 번째는 답변을 거절하는 것도 성능의 일부라는 점입니다. 사용범위를 벗어난 요청을 들어주는 under-refusal도 문제지만, 충분히 답할 수 있는 안전한 질문을 계속 거절하는 over-refusal도 문제입니다. 의료기기가 실제 사용범위 안에서 기능하지 못하는 것이니까요.
두 번째는 응급실을 무조건 가라고 하는 것도 안전한 AI는 아니라는 것입니다. 응급진료가 필요한 환자를 놓치는 under-escalation은 물론이고, 모든 증상에 응급실 방문을 권고하는 over-escalation도 불필요한 검사, 의료자원의 낭비, 환자의 불안과 신뢰 저하를 초래할 수 있습니다. 위험한 환자를 찾아내는 민감도만 높인다고 끝나는 문제가 아니지요. 결국, sensitivity와 specificity 모두 중요하게 봐야 한다는 것입니다.
세 번째는 그럴듯하게 이야기하는 능력과 의학적으로 안전한 의사소통은 다르다는 것입니다. LLM은 틀린 답변도 매우 자신 있게 할 수 있습니다. 사용자가 그 유창함 때문에 답변을 무비판적으로 수용하는 automation bias가 발생할 수 있습니다. 따라서 임상적으로 불확실한 상황에서 얼마나 적절하게 모른다고 말하는지, 사용자가 한계를 실제로 이해하는지도 평가할 수 있다는 것이지요.
마지막으로 재현성의 의미가 기존 AI와 다릅니다. 표현이 조금 달라지는 것은 괜찮을 수 있습니다. 그러나 같은 환자가 말투만 바꾸었다고 응급실 방문 여부나 진단적 결론이 흔들리면 문제가 됩니다. 반복 실행, 동의어 표현, 정보 제시 순서, 긴 대화, 상충되는 정보까지 평가해야 한다는 논의입니다.
그럼 벤치마크 시험 점수가 높으면 충분할까?
FDA의 답은 그렇지 않을 가능성이 높다는 것입니다.
공개된 의료 LLM 벤치마크에는 여러 문제가 있습니다. 학습 데이터에 시험문제가 포함되는 data contamination, 모델들이 시험에 지나치게 최적화되는 benchmark saturation, 그리고 실제 진료 상황과 시험 환경이 다른 representativeness 문제가 있지요.
더구나 실제 의료에서는 질문이 깔끔하게 정리되어 들어오지 않습니다. 환자가 증상을 빠뜨릴 수도 있고, 정보가 모순될 수도 있고, 검사값의 단위를 잘못 전달할 수도 있습니다. 병원마다 업무 흐름도 다르고요.
따라서 FDA는 benchmarking 이후에 별도의 Clinical confirmation을 고려합니다. 가능한 방법으로는 다음과 같은 것들이 제시됩니다.
- Retrospective evaluation: 과거 실제 환자의 입력에 AI를 적용한 뒤 참조표준이나 전문가 판정과 비교
- Shadow deployment: 실제 임상환경에서 AI를 작동시키되 출력을 진료에 사용하지 않고 평가
- Standardized patient interactions: 표준화된 환자 시나리오로 상호작용을 시험
- Clinician adjudication of real cases: 독립적인 의료진이 실제 사례의 입력과 출력을 검토
- Prospective clinical study: 실제 환자에 대한 전향적 연구, 경우에 따라 RCT 수행
중요한 점은 모든 제품에 전향적 RCT가 반드시 필요하다고 제안한 것은 아니다라는 것입니다. 제품의 위험과 사용목적에 따라 어떤 임상적 근거가 적절한지 정하자는 논의입니다. 물론 여기서 나열한 방법들은 법령상 임상시험 관련 요건을 자동으로 면제하는 수단도 아닙니다.
비교대상은 누구인가?
여기서 또 하나 흥미로운 문제가 나옵니다. 생성형 AI가 잘한다고 평가하려면 누구보다 잘해야 할까요?
- 해당 분야 전문의일까요?
- 일반의일까요?
- 표준진료에 대한 전문가 합의일까요?
- 실제로 진료하는 의사들의 중간 정도 성능일까요?
- 아니면 의료진이 AI와 함께 일할 때의 성능일까요?
FDA는 이러한 comparator 선정도 논의 대상으로 제시합니다.
예를 들어 전문의가 부족한 지역에서 일반의의 판단을 지원하는 AI가 있다고 해봅시다. 이 제품을 최고 수준의 전문의와 비교하는 것도 의미가 있지만, AI가 없었을 때 이루어졌을 진료와 비교해 얼마나 달라졌는가를 보는 것도 중요합니다. 또 AI가 의료진을 보조하도록 개발되었다면 AI 단독 성능뿐 아니라 human-AI team의 성능도 고려해야겠지요.
이 지점에서 단순한 AI accuracy와 실제 clinical utility가 갈라집니다. 다만 FDA가 특정 임상적 유용성 지표를 모든 생성형 AI 의료기기에 의무화했다고 해석해서는 안 됩니다. 어떤 기준과 endpoint를 사용할지가 바로 이 문서의 질문 중 하나입니다.
FDA 허가 이후에도 AI는 계속 변한다
기존의 의료기기에서도 시판 후 모니터링은 중요합니다. 그런데 생성형 AI에서는 조금 더 골치 아픈 문제가 있습니다.
예를 들어 오늘까지 잘 작동하던 의료 LLM 제품이 다음 주에도 동일한 성능을 보장할까요? 제조사가 prompt를 수정하거나 RAG 데이터베이스를 업데이트할 수도 있고, 외부 foundation model 공급사가 새로운 버전으로 모델을 교체할 수도 있습니다. 제조사가 전혀 예상하지 못한 출력의 변화가 생길 수 있는 것이지요.
FDA는 이를 고려하여 다음과 같은 시판 후 관리 방법을 제시합니다.
- Periodic benchmarking: 정기적 또는 주요 변경 이후에 사전 정의된 기준으로 다시 평가
- Sample-based clinician review: 실제 사용 결과의 표본을 독립적인 의료진이 검토
- Performance degradation monitoring: 환경, 환자집단, 모델 변화에 따른 성능 저하를 감시
FDA는 한발 더 나아가, 일부 경우에 강력한 시판 후 모니터링을 전제로 시판 전 평가에서 더 큰 불확실성을 허용할 수 있는가라는 질문까지 던집니다.
주의할 점은 이것이 확정된 규제 완화 방침이 아니라는 것입니다. 특히 임상적으로 위험한 제품에서 어느 정도까지 불확실성을 받아들일 수 있는지는 해결된 문제가 아닙니다.
PCCP를 생성형 AI에도 적용할 수 있을까?
의료 AI 규제를 조금 살펴본 분이라면 Predetermined Change Control Plan(PCCP)이 익숙할 겁니다. 미리 정의한 범위 안에서 알고리즘을 변경할 수 있도록 계획을 세우는 체계입니다.
FDA는 생성형 AI에서도 PCCP가 일부 변경을 관리할 수 있을 것으로 보고 있습니다. 하지만 외부 모델 제공자가 새로운 모델 버전을 출시한다거나, 앞으로 발생할 수정의 범위를 정확하게 미리 정할 수 없다면 어떻게 할까요?
FDA가 제시하는 한 가지 가능성은 허가 전 competency benchmark를 기준선(baseline)으로 삼아, 변경 후 다시 benchmarking하는 것입니다. 그러나 어떤 변경을 품질시스템 내에서 관리하고 어떤 변경에 새로운 허가 심사가 필요한지는 이 문서에서 확정하지 않았습니다.
규제 대상 의료기기 제조사라면 모델 버전만 기록하는 것으로 충분하지 않을 수 있습니다. 실제 임상 성능에 영향을 주는 prompt, retrieval, guardrail, 외부 API와 workflow까지 함께 관리할 필요가 있다는 시사점을 얻을 수 있습니다.
Foundation Model과 Agentic AI의 문제
파운데이션 모델은 누가 책임질까?
의료기기 제조사가 OpenAI 같은 외부 기업의 foundation model을 기반으로 제품을 만들었다고 합시다. 제조사는 최종 제품의 안전성과 유효성을 입증해야 하지만, 모델의 학습 데이터나 세부 동작, 잠재적인 실패 유형을 모두 알기는 어렵습니다.
FDA는 이를 위한 가능성으로 Foundation Model Device Master File(MAF)을 검토합니다. 모델 개발사가 모델의 특성, 학습 데이터 출처, 알려진 한계, 임상 관련 성능, 업데이트 정보 등을 FDA에 기밀로 제출하고, 의료기기 제조사가 허가를 받아 해당 자료를 심사에 참조하는 방식입니다.
그렇다고 foundation model에 MAF가 있다는 사실이 그 모델의 의료기기 사용을 허가한다는 의미는 아닙니다. 최종 의료기기의 안전성과 유효성을 증명할 책임은 여전히 제조사에 있습니다. 또한 MAF는 자발적 제출 방안으로 논의되고 있을 뿐입니다.
답하는 AI에서 행동하는 AI로
Agentic AI는 외부 도구를 이용하고 여러 단계를 계획하여 실행하는 시스템입니다. 단순한 의학 지식 Q&A와 달리 AI가 검사 오더를 실행하거나 다른 의료기기를 제어하는 단계까지 간다면 위험의 성격이 달라집니다.
이 경우에는 답변의 정확도 외에도 다음과 같은 역량을 평가할 필요가 있다고 FDA는 논의합니다.
- 여러 단계의 작업을 적절한 순서로 계획하고 실행하는가?
- 작업이 원래 Intended Use를 벗어나는지 인지하는가?
- 외부 도구의 잘못된 출력을 알아차리는가?
- 되돌릴 수 없는 행동 전에 필요한 인간의 감독을 거치는가?
- 도구 실행 실패와 prompt injection에 안전하게 대응하는가?
특히 Agentic AI가 임상기기 제어와 같은 의료기기 기능을 수행하는 상황에서 중요해질 수 있습니다. 다만 임상문서 작성이나 환자 연락과 같은 모든 Agentic AI 기능이 FDA 의료기기 규제 대상이라는 의미는 아닙니다.
한국 식약처: Soombit.ai의 AIRead-CXR 허가
미국에서 생성형 AI 의료기기에 적용할 평가 방식이 논의되는 사이, 한국에서는 실제 허가 사례가 나왔습니다. 식약처는 2026년 4월 1일 국내 최초로 생성형 인공지능 기반 디지털의료기기를 허가했다고 발표했습니다.[2] 대상 제품은 Soombit.ai(숨빗AI)의 AIRead-CXR입니다.
이 제품의 가장 중요한 특징은 흉부 X-ray를 분석해 예비 소견서를 생성한다는 점입니다. 기존의 영상 AI가 결절이나 이상 소견을 탐지하고 표시하는 데 주력했다면, AIRead-CXR은 영상으로부터 자연어 판독문의 초안을 생성한다는 점에서 차이가 있습니다.
허가받은 것은 범용 의료 LLM이 아니다
공개된 제품 사용설명서에 따르면 AIRead-CXR의 모델명은 ACX-01, 허가번호는 D제허26-10호이며 3등급 의료기기입니다.[3] 사용목적은 다음과 같이 명시되어 있습니다.
영상의학과 전문의가 의료기관에서 만 19세 이상 성인의 흉부 X-ray 판독 보조를 위해 사용하는 것으로 흉부 X-ray 영상을 생성형 인공지능 기술로 분석하여 예비 소견서를 생성하는 소프트웨어
여기서 눈여겨볼 표현은 영상의학과 전문의, 성인, 흉부 X-ray, 판독 보조, 예비 소견서입니다. 생성형 AI를 사용한다고 해서 임의의 의료 질문에 답하거나, 모든 장기의 영상을 해석하거나, 최종 판독과 진단을 자율적으로 수행하도록 허가받은 것은 아닙니다. 실제로 허가된 것은 특정 사용자와 특정 입력, 특정 기능을 갖는 소프트웨어입니다.
이 점은 FDA의 Discussion Paper와도 연결됩니다. FDA가 말하는 규제의 대상 역시 기초모델 자체가 아니라 구체적인 Intended Use를 가진 최종 의료기기 기능이기 때문입니다. 다만 한국의 개별 제품 허가 사실이 미국 FDA가 논의한 역량 기반 프레임워크를 채택했다는 의미는 아닙니다.
생성형 판독문은 어떻게 평가해야 할까?
기존의 영상 AI에서는 진단 여부의 진양성, 위양성 등을 비교적 명확하게 정의할 수 있습니다. 반면 판독문에는 표현의 차이가 존재합니다. 예를 들어 동일한 영상에서 경미한 폐기저부 무기폐를 기술할 때 서로 다른 문장이 모두 임상적으로 타당할 수 있겠지요.
따라서 문장 간 유사도만으로는 충분하지 않습니다. 보고서에 포함된 병변 소견이 영상과 일치하는지, 임상적으로 중요한 소견을 누락하지 않았는지, 없는 소견을 생성하지 않았는지, 그리고 전문가가 결과를 검토할 때 실질적인 도움이 되는지를 별도로 살펴볼 필요가 있습니다. 이것은 생성형 영상보고서 평가에 대한 일반적인 방법론적 해석이며, 식약처가 AIRead-CXR 심사에 어떤 지표와 기준을 구체적으로 적용했는지에 대한 공개 자료상의 단정은 아닙니다.
관련 연구 논문과 제품 허가 심사에 사용된 근거는 구별해야 합니다. 공개된 논문의 성능 지표가 곧 식약처의 품목허가 심사에서 사용된 모든 평가 지표 또는 허가 기준과 동일하다고 해석해서는 안 됩니다. 허가된 사용목적과 논문에서 실험한 task의 범위도 구분해야 합니다. 참고로 제품 사용설명서에는 RADPEER 기준 부적격 진단율과 환각 발생비율에 관한 성능 항목이 명시돼 있습니다.[3] 이는 성능평가에서 어떤 개념을 사용했는지 보여주지만, 공개된 사용설명서만으로 전체 품목허가 심사자료를 재구성할 수는 없습니다.
실제 허가 사례가 주는 의미
AIRead-CXR 사례는 생성형 AI라는 기술 유형 그 자체보다 구체적인 의료기기 기능과 사용목적을 정의하는 것이 중요하다는 점을 보여줍니다. 환자 대상의 자유로운 의료 상담 챗봇, 영상의학과 전문의를 위한 예비 판독문 작성기, 검사나 치료 오더를 자율적으로 실행하는 Agentic AI는 모두 생성형 AI 기술을 사용할 수 있지만 위험의 성격이 같지는 않습니다.
특히 AIRead-CXR은 의료진의 판독 보조라는 제한된 task에 초점을 맞추고 있습니다. 이처럼 범위를 한정하는 방식은 평가 대상과 위험을 구체화하는 데 도움이 됩니다. 물론 범위가 한정되었다고 해서 환각, 중요한 소견의 누락, 특정 환자군에서의 성능 저하 문제가 저절로 해결되는 것은 아닙니다.
또 하나 조심할 점은 국내 최초라는 표현입니다. 식약처가 공식 발표한 것은 국내 최초의 생성형 AI 기반 디지털의료기기 허가입니다. 이것을 세계 최초의 모든 종류의 생성형 AI 의료기기 허가라고 일반화하거나, FDA에서 유사 제품을 허가한 적이 없다는 포괄적인 결론으로 바꾸는 것은 별개의 검증이 필요합니다.
마치며
미국 FDA의 문서와 한국 식약처의 허가 사례를 나란히 놓으면 이해가 편리합니다. FDA의 Discussion Paper는 입력과 출력이 열린 생성형 AI를 어떤 위험 프레임워크로 평가하고, 어떤 임상적 근거를 요구하며, 허가 이후 변경을 어떻게 관리할지 묻고 있습니다. 반면 AIRead-CXR은 성인 흉부 X-ray의 예비 소견서 생성이라는 구체적인task에 대해서 실제 허가를 받은 제품입니다.
이 둘을 동일한 규제 체계라고 말할 수는 없습니다. FDA 문서는 규제 방향을 탐색하는 논의이고, 한국의 품목허가는 개별 제품의 사용목적에 대한 행정적 판단이기 때문입니다. 하지만 의료 AI 개발자 입장에서는 같은 질문에 닿습니다. 결국 무엇을 입력받아, 누구에게, 어떤 결과를 내놓고, 그 결과에 의존했을 때 어떤 일이 벌어질 수 있는가 하는 질문입니다.
개인적으로는 생성형 AI 의료기기의 경쟁력이 단순히 더 유창한 문장을 만드는 능력에 있지는 않다고 생각합니다. 특정 임상적 task에서 안전하고 유용한 결과를 일관되게 내는지, 잘못된 결과를 발견할 수 있는 평가 체계가 있는지, 그리고 모델이나 시스템이 달라졌을 때 그 능력을 다시 확인할 수 있는지가 중요하겠지요.
허가받는 것은 모델이 아니라 의료현장에 배포되는 제품입니다. 생성형 AI라는 새로운 기술을 의료에 적용하는 과정에서도 결국 이 원칙이 중심에 있어야 할 것 같습니다.
참고자료
- U.S. FDA, CDRH. Considerations for the Regulation of Generative AI-Enabled Medical Devices: Discussion Paper and Request for Feedback. August 2026. (FDA 공식 소개 및 원문 PDF 연결 페이지)
- 식품의약품안전처. 식약처, 국내 최초 생성형 인공지능 기반 디지털의료기기 허가. 2026-04-01.
- Soombit.ai. AIRead-CXR 사용설명서, ACX-01. IFU-ACX-01-KR_R07, 2026-04-01.
- Soombit.ai. News & Updates. (회사 자료이며 허가 사실은 식약처 공식 보도자료와 구분)
- Patel B, Blumenthal D. A Novel Approach to Overseeing the Clinical Application of Generative AI. JAMA Health Forum. 2026.
- Bergman A, Wachter RM, Emanuel EJ. A Licensure Framework for Autonomous Clinical AI. JAMA. 2026.